Robots.txt e noindex - Como funcionam juntos
O que são "noindex" e "Disallow"
São dois mecanismos diferentes que o Google usa pra decidir se uma página aparece nos resultados de busca.
noindex é uma marcação na própria página, dizendo "não me mostre nos resultados". Pra funcionar, o Google precisa visitar a página e ler essa marcação.
Disallow é uma regra no robots.txt que impede o Google de sequer visitar (rastrear) a página.
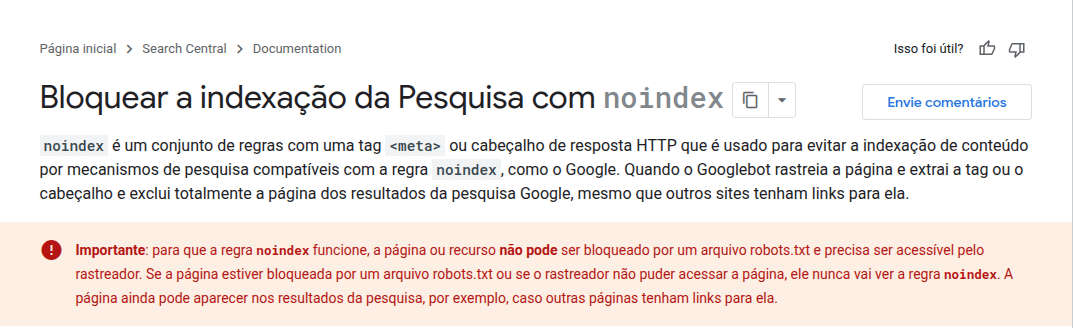
Print retirado da documentação oficial do Google, mostrando que o noindex só funciona se a página não estiver bloqueada por um robots.txt:
Onde essa configuração aparece na loja
No painel administrativo, acesse Configurações > Configurações Gerais, clique na aba SEO e localize um destes blocos:
SEO - Paginação, campo "Paginação - Permitir que as páginas 2, 3... sejam indexadas?"
SEO - Ordenação, campo "Ordenação - Permitir que resultados ordenados sejam indexados?"
SEO - Filtros, campo "Filtros - Permitir que resultados filtrados sejam indexados?"
Quando qualquer um desses campos fica em "Não", a loja aplica os dois mecanismos juntos na URL correspondente: a página recebe noindex e também passa a ter o rastreamento bloqueado no robots.txt. Isso economiza o tempo que o Google gasta rastreando a sua loja, direcionando essa atenção pra produtos e categorias de verdade.
Se a URL já estava indexada antes de você mudar o campo pra "Não", ela pode ficar presa nos resultados do Google. Bloquear o rastreamento impede o Google de visitar a página de novo pra ler o noindex e removê-la dos resultados — as duas regras juntas se anulam nesse caso específico.
Como recuperar uma URL presa
No Google Search Console da sua loja, veja o relatório de páginas indexadas. Se aparecer alguma com o status "Indexada, mas bloqueada pelo robots.txt", mantenha o campo em "Não" e libere só o rastreamento, pra o Google conseguir visitar a página de novo e ler o noindex:
Ainda na aba SEO, no bloco SEO - robots.txt, abra o robots.txt atual da sua loja e copie o conteúdo pro campo Conteúdo do robots.txt — veja como acessar o arquivo atual no artigo sobre a geração automática do robots.txt.
No texto colado, remova só as linhas que bloqueiam esse tipo de URL — contêm "page=" (paginação), "sorting" (ordenação) ou "filters" (filtros), repetidas em mais de um trecho do arquivo. Deixe o resto do arquivo como está.
Clique em Salvar modificações, no final da página.
Aguarde o Google rastrear a página de novo e confirmar a remoção no Search Console — pode levar alguns dias.
Confirmada a remoção, apague o conteúdo do campo Conteúdo do robots.txt (deixe em branco) pra loja voltar a usar o robots.txt padrão da plataforma — que já bloqueia esse tipo de URL de novo, automaticamente, enquanto o campo estiver em "Não".
O robots.txt da loja é revisitado pelo Google periodicamente — o próprio Google cita um cache de até 24 horas —, então uma alteração nesse campo não bloqueia nem libera o rastreamento na mesma hora.
Para aprofundar
Documentação oficial do Google sobre o assunto (conteúdo de terceiro, em inglês, sujeito a mudar):


